タイトル通り。ここではSNO構成のクラスターにワーカーノードを追加した。
第10章 シングルノード OpenShift クラスター用のワーカーノード | Nodes | OpenShift Container Platform | 4.20 | Red Hat Documentation
環境は下記構成のSNOのOpenShift環境。(4.21.11)
基本的には新規構築時のノード設定と同様。
zaki-hmkc.hatenablog.com
SNOのOpenShiftにワーカーノードを追加して負荷を分散させるというのはシナリオとしてあるようだけど、クラスター名とかに"sno"を入れたのは失敗だったな(笑)
ノードマシンを用意
以下スペックで準備 (workerも8コア・16GBと思い込んでてケチったつもりが盛りすぎてた)
- CPU 6core
- RAM 16GB
- ストレージ 120GB
新規構築と同様、NICのMACアドレスをメモしておく。
Assisted Installer
OpenShiftのコンソールの「Fleet management」->「Clusters」から対象クラスターを選択、「Add Hosts」タブを選択。
※ 「Resources」->「Assisted Installer」のクラスター一覧だと「Add Hosts」メニューは無いので注意。

「Add hosts」ボタン押下で新規構築時のノード設定と同じダイアログが開くので、同じ要領で追加ノードの情報を入力、ISOファイルをダウンロードし、VMでマウントしてブートする。

Cluster Managerの画面でノードを認識したら「Install ready hosts」押下して進める。
※ これDNSサーバーの設定追加してなかったのでホスト名がMACアドレスになっている。後述。

Cluster Managerでinstall完了のように見えても、そのままだとノードは追加されない。
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS   ROLES                         AGE   VERSION
sno1.naru.jp-z.jp   Ready    control-plane,master,worker   11d   v1.34.6
前回トラシュー記事を書いた時と同じで、pending状態のcsrがあるのでapproveする。
実行するコマンドは oc get csr -o name | xargs oc adm certificate approve
zaki@cloud-dev2:~/local/ocp$ oc get csr
NAME        AGE   SIGNERNAME                                    REQUESTOR                                                                   REQUESTEDDURATION   CONDITION
csr-4b5vh   48s   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Pending
csr-jntxn   92m   kubernetes.io/kube-apiserver-client           system:ovn-node:sno1.naru.jp-z.jp                                           24h                 Approved,Issued
csr-m5nk7   98m   kubernetes.io/kube-apiserver-client           system:multus:sno1.naru.jp-z.jp                                             24h                 Approved,Issued

zaki@cloud-dev2:~/local/ocp$ oc get csr -o name | xargs oc adm certificate approve
certificatesigningrequest.certificates.k8s.io/csr-4b5vh approved
certificatesigningrequest.certificates.k8s.io/csr-jntxn approved
certificatesigningrequest.certificates.k8s.io/csr-m5nk7 approved

zaki@cloud-dev2:~/local/ocp$ oc get csr
NAME        AGE   SIGNERNAME                                    REQUESTOR                                                                   REQUESTEDDURATION   CONDITION
csr-4b5vh   93s   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Approved,Issued
csr-jntxn   93m   kubernetes.io/kube-apiserver-client           system:ovn-node:sno1.naru.jp-z.jp                                           24h                 Approved,Issued
csr-m5nk7   98m   kubernetes.io/kube-apiserver-client           system:multus:sno1.naru.jp-z.jp                                             24h                 Approved,Issued
これでノードが追加され、Readyになるための処理が開始される。ただpendingのcsrはこのあとも生えてくるので、見つけ次第都度approveする。
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS     ROLES                         AGE   VERSION
bc-24-11-50-40-f3   NotReady   worker                        19s   v1.34.6
sno1.naru.jp-z.jp   Ready      control-plane,master,worker   11d   v1.34.6
zaki@cloud-dev2:~/local/ocp$ oc get csr
NAME        AGE     SIGNERNAME                                    REQUESTOR                                                                   REQUESTEDDURATION   CONDITION
csr-4b5vh   9m23s   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Approved,Issued
csr-6qkqc   7m21s   kubernetes.io/kubelet-serving                 system:node:bc-24-11-50-40-f3                                               <none>              Pending
csr-jntxn   100m    kubernetes.io/kube-apiserver-client           system:ovn-node:sno1.naru.jp-z.jp                                           24h                 Approved,Issued
csr-m5nk7   106m    kubernetes.io/kube-apiserver-client           system:multus:sno1.naru.jp-z.jp                                             24h                 Approved,Issued
zaki@cloud-dev2:~/local/ocp$ oc get csr -o name | xargs oc adm certificate approve
certificatesigningrequest.certificates.k8s.io/csr-4b5vh approved
certificatesigningrequest.certificates.k8s.io/csr-6qkqc approved
certificatesigningrequest.certificates.k8s.io/csr-jntxn approved
certificatesigningrequest.certificates.k8s.io/csr-m5nk7 approved
certificatesigningrequest.certificates.k8s.io/csr-mcqzc approved
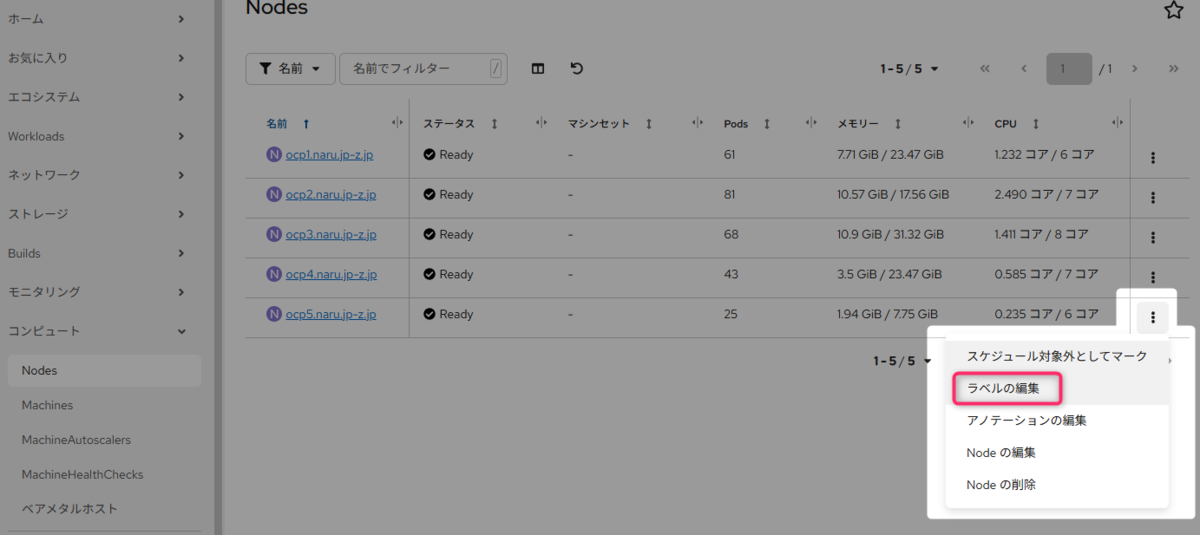
csrの様子をみつつしばらく経過するとReadyになる。
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS   ROLES                         AGE   VERSION
bc-24-11-50-40-f3   Ready    worker                        13m   v1.34.6
sno1.naru.jp-z.jp   Ready    control-plane,master,worker   11d   v1.34.6
webコンソールでもこの通り。

Cluster Managerだと全ノードを一覧する画面が見当たらなくて処理が完了しているのかイマイチわからなかったけど、「Details」を見ると全ノード合計のリソース値になってるので大丈夫だと思われ。(自身なし)

ホスト名について
前述の通りDNS設定抜きでノード追加すると、MACアドレスがそのままノード名として認識するが、OS設定としてのホスト名も同様になっている。
zaki@cloud-dev2:~$ ssh core@192.168.0.111 -i ~/.ssh/id_rsa_4096
The authenticity of host '192.168.0.111 (192.168.0.111)' can't be established.
ED25519 key fingerprint is SHA256:6S64wDPzP+6i1dKkaoTnLiubSQaKgLSzvcj779TzAcg.
This key is not known by any other names.
Are you sure you want to continue connecting (yes/no/[fingerprint])? yes
Warning: Permanently added '192.168.0.111' (ED25519) to the list of known hosts.
Red Hat Enterprise Linux CoreOS 9.6.20260414-0
  Part of OpenShift 4.21, RHCOS is a Kubernetes-native operating system
  managed by the Machine Config Operator (`clusteroperator/machine-config`).

WARNING: Direct SSH access to machines is not recommended; instead,
make configuration changes via `machineconfig` objects:
  https://docs.openshift.com/container-platform/4.21/architecture/architecture-rhcos.html

---
[core@bc-24-11-50-40-f3 ~]$
[core@bc-24-11-50-40-f3 ~]$ hostname
bc-24-11-50-40-f3
「Install ready hosts」押下前にホスト名部分をクリックすれば手動で設定可能。(この時点でDNS設定も更新しましょう)
ノードの削除
ホスト名を設定してなくてMACアドレス状態になってしまったので、いったんノード削除して再構築してみる。
6.2.5. クラスターからのノードの削除 | Nodes | OpenShift Container Platform | 4.20 | Red Hat Documentation
クラウドサービスに統合されている場合はMachineSetリソース管理らしいが、ここはオンプレ。Nodeをdeleteしてやれば良い。
(確認する手順は「6.2.5.1. ベアメタルクラスターからのノードの削除」となる)
ドキュメントにはcordonしてdrainとあってdrainだけで良さそうだけど、一応ドキュメントの手順に従ってみる。
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS   ROLES                         AGE   VERSION
bc-24-11-50-40-f3   Ready    worker                        20h   v1.34.6
sno1.naru.jp-z.jp   Ready    control-plane,master,worker   11d   v1.34.6

### cordonを実行してpodがスケジュールされないようにする
zaki@cloud-dev2:~/local/ocp$ oc adm cordon bc-24-11-50-40-f3
node/bc-24-11-50-40-f3 cordoned
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS                     ROLES                         AGE   VERSION
bc-24-11-50-40-f3   Ready,SchedulingDisabled   worker                        20h   v1.34.6
sno1.naru.jp-z.jp   Ready                      control-plane,master,worker   11d   v1.34.6
この時点ではまだbc-24-11-50-40-f3上のpodはrunningのまま
zaki@cloud-dev2:~/local/ocp$ oc adm drain bc-24-11-50-40-f3 --force=true
node/bc-24-11-50-40-f3 already cordoned
error: unable to drain node "bc-24-11-50-40-f3" due to error: [cannot delete Pods with local storage (use --delete-emptydir-data to override): default/virt-launcher-fedora-cyan-blackbird-23-2vtrn, cannot delete DaemonSet-managed Pods (use --ignore-daemonsets to ignore): openshift-cluster-node-tuning-operator/tuned-dv2vt, openshift-cnv/bridge-marker-zwpqm, openshift-cnv/hostpath-provisioner-csi-9nzls, openshift-cnv/kube-cni-linux-bridge-plugin-9bsk9, openshift-cnv/virt-handler-cp6qw, openshift-dns/dns-default-qkgsv, openshift-dns/node-resolver-f5j27, openshift-image-registry/node-ca-vhvzp, openshift-ingress-canary/ingress-canary-z2q25, openshift-insights/insights-runtime-extractor-2hhbk, openshift-machine-config-operator/machine-config-daemon-zjgnv, openshift-monitoring/node-exporter-gkfdl, openshift-multus/multus-additional-cni-plugins-6kdqf, openshift-multus/multus-t8zmv, openshift-multus/network-metrics-daemon-55r7s, openshift-network-diagnostics/network-check-target-jcsx9, openshift-network-operator/iptables-alerter-7g2jm, openshift-nmstate/nmstate-handler-wg66l, openshift-ovn-kubernetes/ovnkube-node-j5827], continuing command...
There are pending nodes to be drained:
 bc-24-11-50-40-f3
cannot delete Pods with local storage (use --delete-emptydir-data to override): default/virt-launcher-fedora-cyan-blackbird-23-2vtrn
cannot delete DaemonSet-managed Pods (use --ignore-daemonsets to ignore): openshift-cluster-node-tuning-operator/tuned-dv2vt, openshift-cnv/bridge-marker-zwpqm, openshift-cnv/hostpath-provisioner-csi-9nzls, openshift-cnv/kube-cni-linux-bridge-plugin-9bsk9, openshift-cnv/virt-handler-cp6qw, openshift-dns/dns-default-qkgsv, openshift-dns/node-resolver-f5j27, openshift-image-registry/node-ca-vhvzp, openshift-ingress-canary/ingress-canary-z2q25, openshift-insights/insights-runtime-extractor-2hhbk, openshift-machine-config-operator/machine-config-daemon-zjgnv, openshift-monitoring/node-exporter-gkfdl, openshift-multus/multus-additional-cni-plugins-6kdqf, openshift-multus/multus-t8zmv, openshift-multus/network-metrics-daemon-55r7s, openshift-network-diagnostics/network-check-target-jcsx9, openshift-network-operator/iptables-alerter-7g2jm, openshift-nmstate/nmstate-handler-wg66l, openshift-ovn-kubernetes/ovnkube-node-j5827
オプション足りないよなーと思ったけどその通り。
daemonsetと削除系フラグを追加して再実行。
(※ ここで強制削除しているpod/virt-launcher-fedora-cyan-blackbird-23-2vtrnは、削除予定ノード上にあるhostPathを使ったVirtualMachineを管理してるpodなんだけど、podは消えたけどVMは消えなかったので、起動できないVMが残骸として残った)
zaki@cloud-dev2:~/local/ocp$ oc adm drain bc-24-11-50-40-f3 --force=true --delete-emptydir-data --ignore-daemonsets
node/bc-24-11-50-40-f3 already cordoned
Warning: ignoring DaemonSet-managed Pods: openshift-cluster-node-tuning-operator/tuned-dv2vt, openshift-cnv/bridge-marker-zwpqm, openshift-cnv/hostpath-provisioner-csi-9nzls, openshift-cnv/kube-cni-linux-bridge-plugin-9bsk9, openshift-cnv/virt-handler-cp6qw, openshift-dns/dns-default-qkgsv, openshift-dns/node-resolver-f5j27, openshift-image-registry/node-ca-vhvzp, openshift-ingress-canary/ingress-canary-z2q25, openshift-insights/insights-runtime-extractor-2hhbk, openshift-machine-config-operator/machine-config-daemon-zjgnv, openshift-monitoring/node-exporter-gkfdl, openshift-multus/multus-additional-cni-plugins-6kdqf, openshift-multus/multus-t8zmv, openshift-multus/network-metrics-daemon-55r7s, openshift-network-diagnostics/network-check-target-jcsx9, openshift-network-operator/iptables-alerter-7g2jm, openshift-nmstate/nmstate-handler-wg66l, openshift-ovn-kubernetes/ovnkube-node-j5827
evicting pod openshift-monitoring/telemeter-client-5fb6966cbc-mgqdz
evicting pod openshift-image-registry/image-pruner-29648160-44prv
evicting pod default/virt-launcher-fedora-cyan-blackbird-23-2vtrn
evicting pod openshift-cnv/hpp-pool-local-bc-24-11-50-40-f3-784fc95654-tcj56
pod/image-pruner-29648160-44prv evicted
pod/hpp-pool-local-bc-24-11-50-40-f3-784fc95654-tcj56 evicted
pod/telemeter-client-5fb6966cbc-mgqdz evicted
pod/virt-launcher-fedora-cyan-blackbird-23-2vtrn evicted
node/bc-24-11-50-40-f3 drained
これでノード削除。
zaki@cloud-dev2:~/local/ocp$ oc delete node bc-24-11-50-40-f3
node "bc-24-11-50-40-f3" deleted
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS   ROLES                         AGE   VERSION
sno1.naru.jp-z.jp   Ready    control-plane,master,worker   11d   v1.34.6
これで追加したworkerノードをシャットダウンする。
get pod -o wideの状態も最初の1ノード目のみでrunningになってることが確認できる。
・・・ただCluster Managerの方はこの時点では残ったままだ。
1時間くらいするとDetailsのTotal vCPUは正しい値になった。
さらに待てばノードは行方不明状態になるので、メニューからremoveできる。
(メッセージの雰囲気から、ノード削除については状態が同期されなさそう)


ノードの再作成
DNS設定を行った上で同じ操作を実施。念のためNICを再作成してMACアドレスを変化させている。
(が、ベアメタルだとこの手は使えないので、同一MACアドレスでもきっと大丈夫)
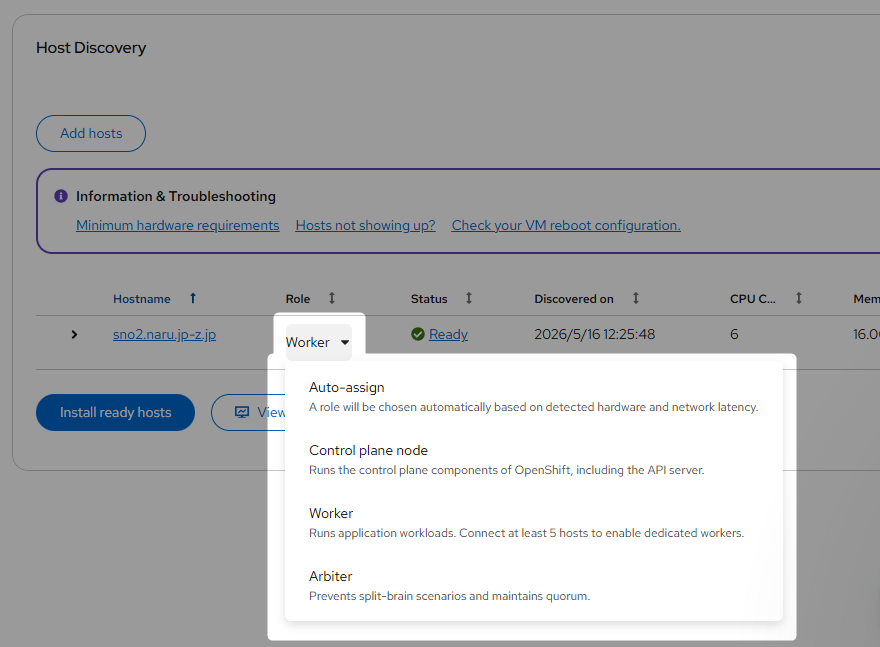
あと初回は気が付かなかったけど、Roleの部分のドロップダウンメニューでWorker以外としてもノード追加ができそう。(Control plane以外はなじみが無いのでわからんけど)
zaki@cloud-dev2:~/local/ocp$ oc get csr
NAME        AGE   SIGNERNAME                                    REQUESTOR                                                                   REQUESTEDDURATION   CONDITION
csr-6fhlw   27s   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Pending
csr-j5cgc   30m   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Pending
csr-rmwdf   15m   kubernetes.io/kube-apiserver-client-kubelet   system:serviceaccount:openshift-machine-config-operator:node-bootstrapper   <none>              Pending
zaki@cloud-dev2:~/local/ocp$ oc get csr -o name | xargs oc adm certificate approve
certificatesigningrequest.certificates.k8s.io/csr-6fhlw approved
certificatesigningrequest.certificates.k8s.io/csr-j5cgc approved
certificatesigningrequest.certificates.k8s.io/csr-rmwdf approved
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS     ROLES                         AGE   VERSION
sno1.naru.jp-z.jp   Ready      control-plane,master,worker   12d   v1.34.6
sno2.naru.jp-z.jp   NotReady   worker                        5s    v1.34.6
csrを何度かapproveしてこの通り、DNSで設定したノード名としてクラスターに追加された。
zaki@cloud-dev2:~/local/ocp$ oc get node
NAME                STATUS   ROLES                         AGE   VERSION
sno1.naru.jp-z.jp   Ready    control-plane,master,worker   12d   v1.34.6
sno2.naru.jp-z.jp   Ready    worker                        11m   v1.34.6

手作業のノード追加はCluster Managerの画面に出てこないのでうっかり見落としがちだけど、DNS設定(特に逆引きのはず)を忘れないように。
※ Assisted Installerで入力するのはIPアドレスのみなので、IPアドレスからホスト名を引ける必要がある…はず。
[core@sno2 ~]$ dig -x 192.168.0.111

; <<>> DiG 9.16.23-RH <<>> -x 192.168.0.111
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 21311
;; flags: qr aa rd ra; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 1232
;; QUESTION SECTION:
;111.0.168.192.in-addr.arpa.    IN      PTR

;; ANSWER SECTION:
111.0.168.192.in-addr.arpa. 0   IN      PTR     sno2.naru.jp-z.jp.

;; Query time: 1 msec
;; SERVER: 192.168.0.4#53(192.168.0.4)
;; WHEN: Sat May 16 04:22:17 UTC 2026
;; MSG SIZE  rcvd: 86
たぶん追加ノードとか関係なく、ホストに対して逆引きのDNS設定をちゃんとしておくとノード名として使われるのかも。
(初回クラスター構築時はノードのDNSは設定してあったので)